Por qué publicamos los números exactos
La mayoría de los productos de monitoreo tratan su lógica de alertas como una caja negra: algo se sintió mal, así que recibiste un correo. Eso funciona bien hasta la primera falsa alarma un sábado por la noche —o peor, el primer problema real que nunca alertó en absoluto. Después de eso, nadie en el equipo confía en la herramienta.
Un equipo de AV de iglesia corre sobre la confianza en el silencio. Si Pulse está callado, la cabina debería estar genuinamente sana; si Pulse habla, debería genuinamente valer la pena caminar a la cabina. Eso solo funciona si todos —el director técnico, el voluntario del domingo, el pastor echando un ojo a un teléfono— saben exactamente dónde están las líneas. Así que aquí están: cada umbral, cada margen de recuperación, cada enfriamiento, en una referencia.
Las líneas rojas de recursos
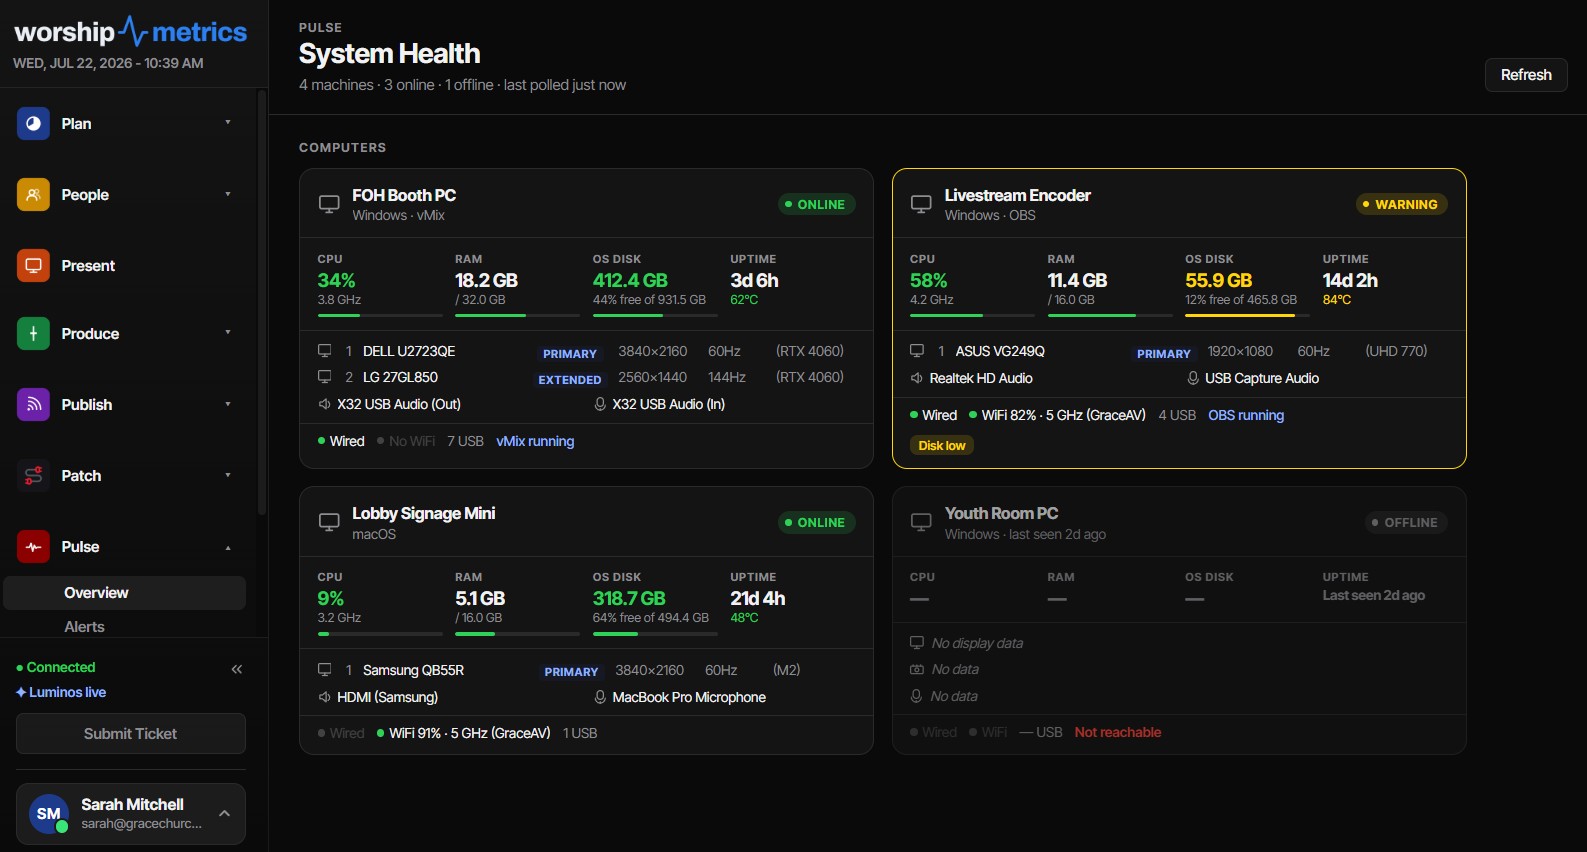
Cada computadora corriendo la app de escritorio Tech Manager reporta carga de CPU, memoria, espacio en disco, y temperatura de CPU continuamente. Cuatro condiciones disparan una alerta crítica de recursos:
| Condición | La alerta se dispara en | Se recupera bajo | Enfriamiento de re-alerta |
|---|---|---|---|
| Carga de CPU | ≥ 90% | 85% | 30 minutos |
| RAM usada | ≥ 90% | 85% | 30 minutos |
| Espacio libre en disco | ≤ 5% | 8% libre | 30 minutos |
| Temperatura de CPU | ≥ 95°C | 92°C | 30 minutos |
Por qué estos números particulares:
- CPU al 90% es donde la producción en vivo empieza a doler. Los encoders descartan frames, el software de presentación se entrecorta en las transiciones de diapositivas, y las interfaces de audio empiezan a crujir mucho antes de que la máquina de verdad se clave en 100%. Noventa por ciento es el último punto donde todavía puedes intervenir con gracia —cerrar el navegador que alguien dejó abierto, pausar el respaldo, bajar un bitrate.
- RAM al 90% significa que el sistema operativo está por empezar a paginar al disco, y en una máquina que también está codificando video, la paginación es donde “un poco lento” se vuelve “congelado a mitad del servicio”.
- Disco al 5% libre es el asesino de grabaciones. Una captura multipista o una grabación de stream local puede comerse gigabytes por hora, y Windows mismo se porta mal cuando el disco del sistema se seca. Cinco por ciento es la alarma; nunca debería llegar ahí si actúas.
- 95°C es territorio de throttle para casi cualquier CPU moderno. Una máquina de cabina así de caliente está ahogada de polvo, sentada en un gabinete sellado, o corriendo con un ventilador fallido —todo arreglable un martes, ninguno arreglable a las 9:58 de un domingo por la mañana.
Un detalle que vale conocer: el correo de alerta y el badge en pantalla leen de las mismas constantes. Lo que ves en la app y lo que aterriza en tu bandeja nunca pueden estar en desacuerdo sobre dónde está la línea.
Histéresis: por qué el número de recuperación es distinto
Fíjate en que cada alerta se recupera en un valor distinto del que la disparó. Ese hueco se llama histéresis, y existe porque las máquinas reales flotan.
Imagina un CPU rebotando entre 89% y 91% durante un render. Si la alerta se disparara en 90% y se limpiara en 90%, recibirías una alerta, una recuperación, una alerta, una recuperación —docenas de correos describiendo una situación en curso. En su lugar, Pulse requiere que la máquina caiga significativamente de vuelta dentro de la zona segura (85% para CPU y RAM, 8% libre para disco, 92°C para temperatura) antes de que la alerta se considere resuelta y elegible para dispararse de nuevo.
Encima de la histéresis se sienta un enfriamiento de 30 minutos por máquina: incluso una máquina que legítimamente se dispara, se recupera, y se dispara de nuevo envía a lo mucho una re-alerta por media hora. Entre los dos mecanismos, un dispositivo tambaleante produce un correo por incidente —no cuarenta.
Detección de desconexión: 90 segundos al badge, cinco minutos al correo
La detección de desconexión corre sobre latidos en capas de cada máquina de cabina:
- Un latido de telemetría ligero cada 15 segundos —CPU, RAM, temperatura, tiempo activo— sobre una conexión WebSocket persistente, con un respaldo HTTPS si el socket está bloqueado.
- Un latido completo cada 60 segundos cargando la instantánea completa de hardware y la salud de cada dispositivo de AV que esa máquina vigila.
De esos latidos, dos umbrales de desconexión distintos sirven a dos propósitos distintos:
| Señal | Umbral | Propósito |
|---|---|---|
| El badge en línea cambia a desconectado | 90 segundos sin un latido (tres latidos ligeros perdidos) | Estado rápido y honesto en la cuadrícula de máquinas de Pulse |
| Correo de alerta de desconexión | Más de 5 minutos de silencio | Notificación de alta confianza de “esto es un corte real” |
| Caída de WebSocket | Atrapada en ~60 segundos por un temporizador de gracia | Atrapa un cable jalado más rápido que el ciclo de sondeo |
| Equipo de AV monitoreado (cámaras, consolas, switchers) | Configurable por dispositivo, 60 segundos por defecto | Ajustable a qué tan nerviosa es la red de cada dispositivo |
| Pantallas de señalización | 30 minutos | Las pantallas que duermen en horario no deberían alertar a nadie |
El badge de 90 segundos y el correo de 5 minutos son deliberadamente distintos. Un badge se puede dar el lujo de ser saltón —no cuesta nada echarle un ojo. Un correo interrumpe la noche de alguien, así que espera lo suficiente para descartar un hipo de router o una breve renegociación de WiFi.
Dos propiedades hacen esto confiable en la práctica. Primero, la verificación de desconexión corre del lado del servidor cada cinco minutos, haya o no alguien con una página abierta —la detección nunca depende de un humano viendo un tablero. Segundo, cada corte alerta exactamente una vez: un reclamo atómico en la base de datos garantiza que aunque múltiples verificaciones compitan, solo un correo sale, y cuando la máquina regresa la alerta se auto-resuelve en el feed.
Equipo de AV monitoreado: todos tienen que estar de acuerdo en que está caído
Las computadoras de cabina no son lo único que Pulse vigila. Las cámaras, consolas digitales, switchers, y otro equipo en red marcado “Alertar cuando esté desconectado” se monitorean también —pero con un giro importante.
Una sola máquina de cabina perdiendo su ruta a una cámara no prueba que la cámara esté caída. Quizá un puerto de switch murió, quizá alguien desconectó el patch cable equivocado, quizá el propio NIC de esa máquina está inestable. Así que Pulse usa un resumen multi-observador: un dispositivo monitoreado solo alarma cuando es inalcanzable desde cada máquina de telemetría en la red. La mala ruta de red de una cabina nunca puede alertar a todo tu equipo sobre una cámara que en realidad está bien.
El resumen produce cinco estados honestos —en línea, degradado, obsoleto, desconectado, desconocido— y solo los observadores frescos obtienen un voto. Una máquina de cabina que se ha quedado callada por 10 minutos se excluye de la decisión, y un dispositivo cuyos únicos observadores se han quedado todos callados se muestra como obsoleto en lugar de congelado en un engañoso “en línea”. El retraso de alerta por dispositivo es de 60 segundos por defecto y es configurable, así que a una cámara en una VLAN congestionada se le puede dar más holgura que a la consola sentada a un salto de switch.
Si tu lista de equipo vive en una hoja de cálculo hoy, este resumen es uno de los mejores argumentos para mantener un inventario de AV en vivo en su lugar —y si los dispositivos en tu red se caen más de lo que deberían, el arreglo subyacente es usualmente el diseño de red, no el monitoreo.
Caídas de stream y verificaciones de audio pre-servicio
Dos tipos de alerta más completan la imagen:
- Caída de livestream. Los latidos cargan telemetría de encoder de OBS o vMix —bitrate versus objetivo, porcentaje de frames perdidos, carga del encoder, tasa de frames, escena actual. Si un stream deja el estado “en vivo” por cualquier razón que no sea que alguien presione Stop en la app, el dueño de la organización, admins, y operadores reciben un correo de alerta de caída dentro de una ventana de enfriamiento. Si eso alguna vez te pasa a mitad del servicio, hemos escrito un manual de recuperación calmado para exactamente ese momento.
- Estado de audio. Una salida o entrada por defecto en silencio o casi silenciosa (salida en o bajo 10%) dispara una advertencia pre-servicio de “revisa el audio” —la alerta que atrapa la falla clásica de “el stream estaba perfecto excepto que estaba en silencio” antes de que alguien le dé a Salir en Vivo.
Detección de patrones: los umbrales detrás de “Necesita atención”
Algunos problemas nunca disparan una sola línea roja pero son obvios a lo largo del tiempo o entre dispositivos. Pulse Insights vigila esos patrones, con sus propios umbrales publicados:
- Pérdida de paquetes ≥ 20% en la ruta de red de un dispositivo
- Latencia en 2× la línea base propia de ese dispositivo (y al menos 30 ms) —medida contra su normal, no un número universal
- La misma alerta tambaleándose 4+ veces en 24 horas
- Medio de grabación agotándose —marcado bajo 30 minutos restantes, urgentemente bajo 10
- Una máquina callada por más de una hora
Y una regla de escalamiento que importa para las iglesias de varias salas y varios campus: un problema abarcando tres o más dispositivos escala de advertencia a crítico automáticamente. Una cámara inestable es una molestia; cinco a la vez es la red.
Dónde te llegan las alertas
Los umbrales solo importan si la alerta aterriza en algún lugar donde alguien la verá:
- El correo es el canal garantizado —cada alerta crítica produce uno.
- Las notificaciones push al teléfono llegan como notificaciones reales del SO vía web push. En iOS 16.4 o posterior, instala la web app de WorshipMetrics a tu pantalla de inicio y los push aparecen como los de cualquier app nativa, con el nombre e ícono de la app —sin descarga separada de tienda de apps.
- Las notificaciones dentro de la app se escriben siempre, así que el registro existe aunque un push se pierda.
- Los avisos de escritorio notifican a cualquiera trabajando en una máquina de cabina.
- Las páginas de Pulse abiertas se actualizan en vivo —sin refrescar para ver una alerta aparecer o resolverse.
Cada alerta lleva una severidad (info, advertencia, crítica) y una de seis áreas (Hardware, Sistema, Stream, Audio, Red, Otro). Cada miembro del equipo puede suscribirse por tipo de alerta y ajustar qué áreas llegan a qué canales, así que el voluntario que corre el audio no recibe alertas de una pantalla de señalización. El feed completo de alertas guarda 90 días de historial con filtros de severidad y área —suficiente para responder “¿ha pasado esto antes?” con datos en lugar de memoria. Ese historial es también una herramienta de entrenamiento genuinamente útil para equipos de voluntarios: revisar las alertas del mes pasado juntos enseña patrones de falla más rápido que cualquier hipótesis.
Cómo lo maneja WorshipMetrics
Todo en esta referencia es el comportamiento estándar de Pulse, la capa de monitoreo de WorshipMetrics: la app de escritorio Tech Manager recolecta telemetría de cada máquina de cabina, la nube vigila la flota las 24 horas, y los umbrales de arriba deciden —consistentemente, y a la vista— cuándo tu equipo se entera. La telemetría de salud del stream fluye automáticamente de los mismos latidos que impulsan live streaming, así que no hay nada extra que configurar para recibir alertas de caída.
Los números son deliberados, la mecánica anti-tambaleo es deliberada, y nada de ello es ajustable hasta la insignificancia: cuando Pulse está callado, tu cabina está sana, y cuando habla, vale la caminata.