Primero, el manual de recuperación de dos minutos
El stream está caído, el servicio sigue, y alguien acaba de mandar un mensaje “¿el stream se supone que esté apagado?” Trabaja esta lista en orden —cada paso toma segundos:
- Revisa el encoder primero. ¿OBS/vMix sigue corriendo y sigue “transmitiendo”? Un encoder colapsado es la causa más común y el arreglo más rápido —reinicia la salida del stream, no la máquina entera.
- Revisa el estado de conexión del encoder. ¿Frames perdidos trepando? ¿Bitrate en cero? Eso es red, no software. Ve al paso 3. ¿Bitrate sano pero la plataforma muestra offline? Eso es río abajo —paso 4.
- Revisa la ruta de red. ¿Puede la máquina de la cabina cargar cualquier sitio web? Si no: revisa el switch/router del que cuelga el encoder. Si el internet del edificio está caído por completo, tu recuperación es un hotspot de teléfono en el encoder —baja el bitrate a 2,500 Kbps primero.
- Revisa la plataforma. Si el encoder dice que está enviando y el destino dice que no está llegando nada, reinicia la salida del stream para forzar una conexión fresca. Si un destino está caído pero otros están en vivo, es problema de esa plataforma —déjalo ir y sigue.
- Publica una vez, con calma. Un mensaje en la plataforma donde tu congregación ve: “Tuvimos un problema técnico —el stream está de vuelta, y el servicio completo se publicará después.” Luego deja de manejar comentarios y termina el servicio.
Lo que no deberías hacer a media misa: reiniciar la máquina de la cabina por una corazonada, reteclear las claves de stream, o cambiar múltiples configuraciones a la vez. Cada cambio no controlado hace el diagnóstico post-servicio más difícil.
Después del servicio: encuentra la causa real
Un stream caído siempre tiene una historia, y la historia está en los datos —si algo la estaba registrando. Las preguntas que importan:
- ¿Cómo se veía el historial de bitrate en los diez minutos antes de la caída? Un declive lento apunta a congestión de red; un acantilado apunta a un crash o desconexión.
- ¿Estaba el encoder bajo carga? ¿Picos de CPU de un cambio de escena, una actualización corriendo en el fondo, un throttle térmico?
- ¿Cambió algo más en la red —un respaldo arrancando, una sala llena de teléfonos pegándole al WiFi de invitados?
- ¿Ha pasado esto antes, en un patrón? ¿Tercer domingo, mañanas frías, la semana en que alguien “ordenó” el rack?
Si tu respuesta a esto es “no tenemos idea,” eso no es un problema de diagnóstico —es un problema de monitoreo.
El arreglo real: entérate antes de que la congregación lo haga
Las iglesias que se recuperan de las caídas de stream en segundos en lugar de correr apuradas todas tienen la misma arquitectura:
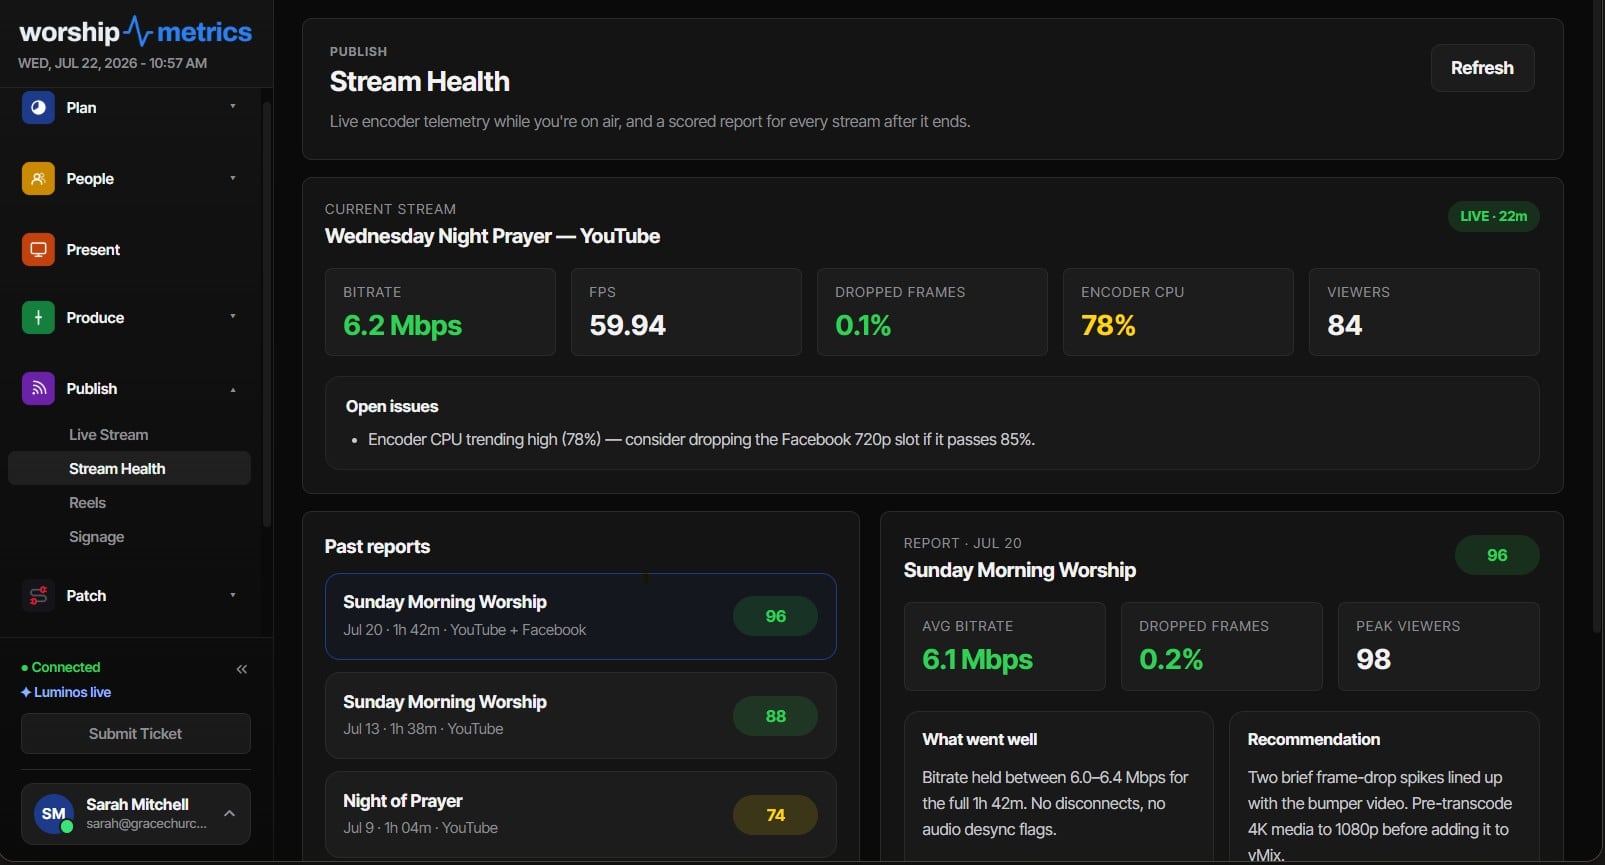
- Monitoreo continuo de salud del stream —bitrate, frames perdidos, y carga del encoder vigilados en tiempo real, con historial al que puedes mirar atrás
- Alertas que disparan en la degradación, no solo en la falla —quieres la advertencia de “el bitrate está cayendo” mientras aún hay tiempo de actuar
- Un feed que sale vía restreaming —para que una sola acción de recuperación restaure cada destino a la vez (ve restreaming para iglesias)
- Grabación automática río arriba —para que hasta una noche de stream accidentada aún produzca un archivo limpio que publicar
- Un humano a quien llamar —porque la peor versión de esta historia es estar solo con ella a las 9:07am
Esta es exactamente la arquitectura que el live streaming de WorshipMetrics provee: el stream corre a través de la plataforma, así que la plataforma ve la caída en el momento en que pasa, te alerta de inmediato, y 910-WORSHIP responde siete días a la semana —incluyendo el domingo por la mañana— con los datos de salud en vivo de tu sistema ya en pantalla.
El sistema de alarma de mensaje-de-la-congregación es gratis, pero te cuesta un poco de credibilidad cada domingo que dispara. Reemplázalo con monitoreo, y la próxima caída se vuelve una nota al pie en lugar de una historia.