La alerta de las 3 AM que nadie necesitaba
Aquí está el modo de falla que silenciosamente mata la confianza en todo sistema de monitoreo: son las 3 AM de un jueves, un puerto de switch en la cabina tiene un hipo de noventa segundos, y una computadora pierde brevemente su ruta hacia una cámara PTZ. La cámara está bien. La cámara nunca dejó de funcionar. Pero la herramienta de monitoreo solo tenía la palabra de esa única computadora, así que hizo lo único que podía —declaró la cámara desconectada y despertó al director técnico.
Haz eso dos veces y pasa algo peor que el sueño perdido: el equipo deja de creerle a las alertas. La siguiente alerta recibe un encogimiento de hombros en lugar de una respuesta, y la única vez que la cámara realmente está muerta un sábado por la noche, nadie camina a la cabina a revisar.
El arreglo no es un retraso más largo ni una notificación más silenciosa. El arreglo es estructural: nunca dejar que la opinión de una sola máquina sobre la red se convierta en el veredicto de todo el sistema. Eso es lo que hace un resumen de salud multi-observador, y este artículo recorre exactamente cómo funciona —los cinco estados de salud, por qué “desconectado” requiere acuerdo unánime, de qué te protege la ventana de obsolescencia de 10 minutos, y dónde encaja el retraso de alerta por dispositivo.
Qué es un “observador”
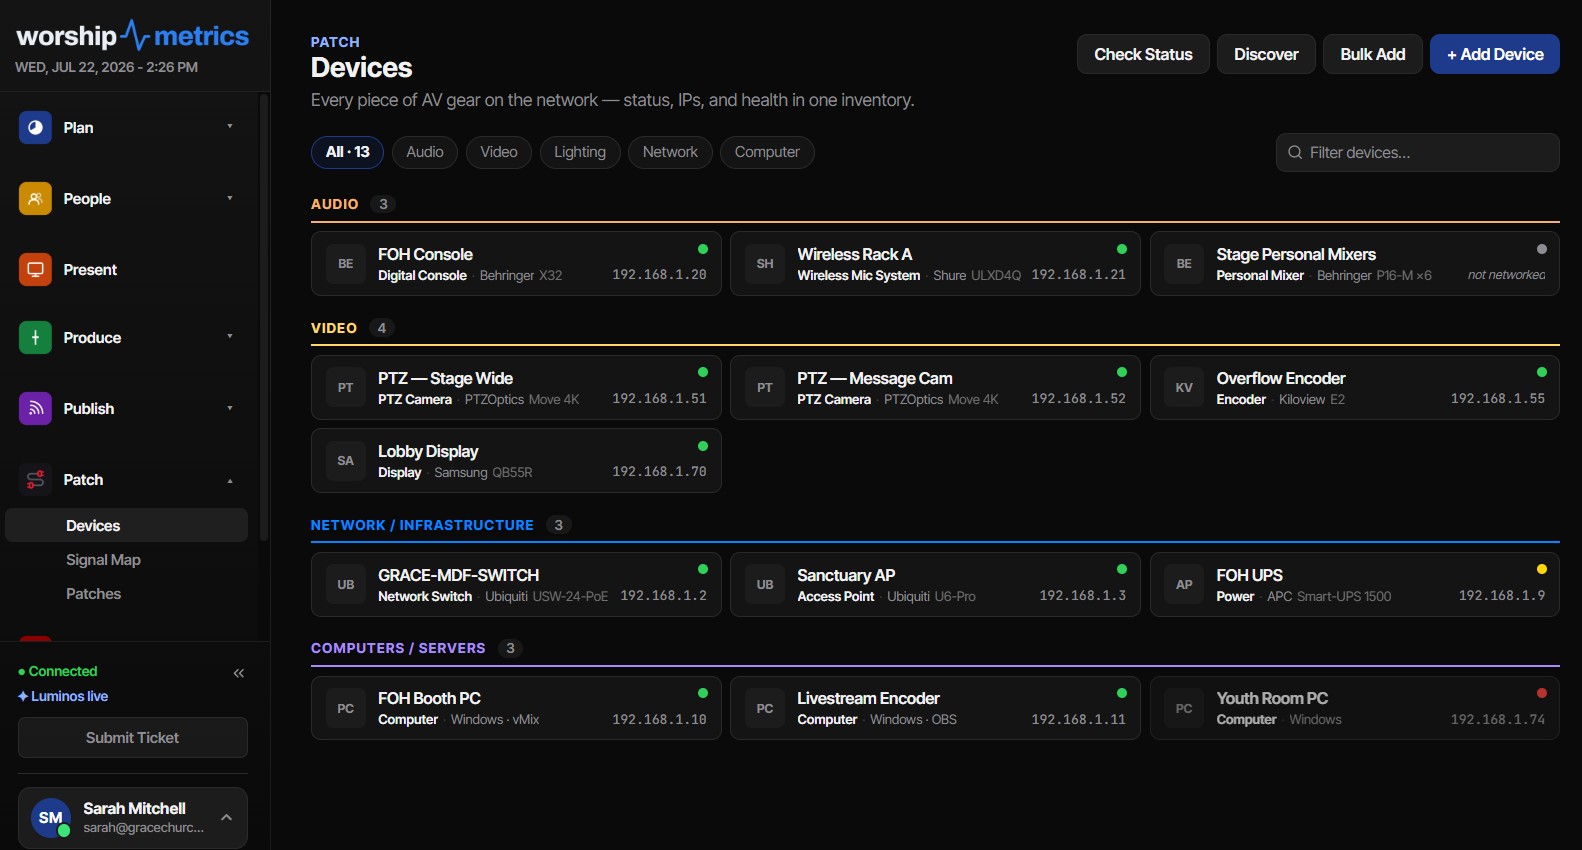
Cada computadora de tu edificio que corre la app de escritorio Tech Manager es más que una máquina monitoreada —también es una vigilante. Junto a su propia telemetría (un latido ligero cada 15 segundos, un latido completo cada 60 segundos), cada máquina sondea el equipo AV en red que has marcado “Alertar cuando esté desconectado” —cámaras, consolas digitales, switchers de video, cualquier cosa con una dirección IP que te importe el domingo— y reporta lo que encontró en su latido.
Eso significa que una cámara en tu sistema no está “arriba” o “abajo” en abstracto. Está alcanzable desde la PC de front-of-house, alcanzable desde la máquina de streaming, inalcanzable desde el reproductor de señalización del lobby. Cada máquina aporta una observación, y la nube consolida esas observaciones en un solo veredicto por dispositivo.
Si solo tienes una máquina corriendo Tech Manager, el resumen sigue funcionando —simplemente tienes un jurado de uno, y el retraso de alerta por dispositivo (más sobre eso abajo) se convierte en tu defensa principal contra los parpadeos. Pero en el momento en que tienes dos o más máquinas de cabina, el resumen empieza a hacer algo que un vigilante solitario nunca puede: distinguir “la cámara está caída” de “una ruta hacia la cámara está caída.” Esos son problemas diferentes con arreglos diferentes, y tu teléfono solo debería vibrar por uno de ellos.
Los cinco estados, y qué te dice cada uno
El resumen resuelve cada dispositivo monitoreado en uno de cinco estados. Cada uno es una afirmación distinta y honesta:
| Estado | Qué significa | Qué hacer |
|---|---|---|
| En línea | Los observadores frescos pueden alcanzar el dispositivo | Nada —esta es la meta |
| Degradado | Los observadores no concuerdan: unos lo alcanzan, otros no | Investiga la ruta, no el dispositivo —un puerto de switch, un patch cable, el NIC de una máquina |
| Obsoleto | Los propios observadores se han quedado callados —sin reporte fresco en 10 minutos | Revisa las máquinas de cabina; el estado real del dispositivo es actualmente inconocible |
| Desconectado | Cada observador fresco concuerda en que el dispositivo es inalcanzable | Esto es real —la caminata a la cabina vale la pena |
| Desconocido | No hay observación alguna con qué trabajar | Usualmente un dispositivo recién agregado que ninguna máquina ha sondeado todavía |
El estado que la mayoría de las herramientas no tienen —y el que ahorra la mayor confusión— es degradado. Cuando tu PC de streaming puede ver la cámara pero la máquina de front-of-house no, eso no es un problema de cámara, y llamarlo “desconectado” te mandaría a solucionar la cosa equivocada por completo. Degradado te apunta al culpable real: una ruta de red. Si tus dispositivos aterrizan en degradado más seguido de lo que deberían, el problema de fondo casi siempre es el diseño de switches y VLANs y no el equipo mismo —nuestras guías de diseño de red de iglesia para AV y de cuáles señales AV sobreviven un switch de red cubren los arreglos.
Por qué “desconectado” requiere unanimidad
La regla central del resumen es deliberadamente estricta: un dispositivo solo se declara desconectado cuando cada observador fresco concuerda en que es inalcanzable.
Un observador disidente —una máquina en cualquier parte del edificio que todavía puede alcanzar la cámara— veta el veredicto de desconectado. Eso suena cauteloso, pero piensa en lo que realmente cuesta cada resultado:
- Una falsa alerta de desconexión despierta a alguien, erosiona la confianza, y entrena al equipo a ignorar el sistema.
- Un breve retraso en una alerta de desconexión verdadera cuesta, a lo mucho, los segundos que le toma al último observador confirmar lo que los otros ya reportaron.
Cuando un dispositivo genuinamente muere —la fuente de poder falla, alguien lo desconecta, el dispositivo mismo se congela— cada observador lo pierde esencialmente en el mismo momento, así que la unanimidad llega casi de inmediato. Los únicos escenarios donde los observadores no concuerdan son precisamente los escenarios donde el dispositivo está bien y algo en medio está roto. Requerir acuerdo no retrasa las alertas reales; filtra las falsas.
Hay un beneficio más silencioso, también. Como el veredicto se construye desde puntos de vista independientes, la vista de la flota se mantiene veraz durante problemas parciales de red. Durante una falla de switch que tumba media sala, verás un grupo de estados degradados y desconectados que se mapea a tu topología física —lo que a menudo basta para identificar el switch fallido antes de que alguien toque un cable. Las iglesias que mantienen un inventario AV vivo con ubicaciones adjuntas le sacan el máximo a esto: el patrón de estados es el diagnóstico.
La ventana de obsolescencia de 10 minutos: honesto sobre tranquilizador
Un observador solo tiene permitido votar mientras sus reportes están frescos. Si una máquina de cabina se queda callada —apagada por la semana, a media actualización, o ella misma fuera de la red— sus últimas observaciones caducan después de 10 minutos, y queda excluida de toda decisión del resumen hasta que reporte de nuevo.
Esta ventana hace dos trabajos a la vez.
Primero, evita que un observador muerto bloquee alertas reales. Sin manejo de obsolescencia, una máquina que reportó “cámara alcanzable” y luego se estrelló seguiría vetando el veredicto de desconectado para siempre, manteniendo a todo el sistema rehén de un reporte del pasado.
Segundo —y esta es la parte que la mayoría de los diseños de monitoreo hacen mal— evita que un observador muerto finja buenas noticias. Si cada máquina que vigila un dispositivo se ha quedado callada, la respuesta honesta no es “en línea” (congelado en el último estado conocido) ni “desconectado” (nadie observó eso en realidad). La respuesta honesta es obsoleto: actualmente no tenemos ojos frescos sobre este dispositivo. El dashboard dice exactamente eso, en lugar de consolarte con una luz verde respaldada por nada.
Diez minutos es un compromiso deliberado. Las máquinas de cabina laten cada 60 segundos y ellas mismas se marcan desconectadas tras 90 segundos de silencio, así que una ventana de observación de 10 minutos tolera reinicios, actualizaciones, y caídas breves de red sin agitar los estados de los dispositivos —mientras sigue garantizando que ningún veredicto se construya jamás sobre datos de más de 10 minutos de edad. (Si una máquina de cabina se queda callada, eso dispara su propia detección de desconexión en su propio reloj más rápido —la referencia completa de umbrales presenta cada temporizador lado a lado.)
El retraso de alerta por dispositivo: holgura donde cada dispositivo la necesita
La unanimidad maneja el desacuerdo entre observadores. El retraso de alerta por dispositivo maneja la otra molestia: los parpadeos momentáneos que todos los observadores ven a la vez.
Algunos dispositivos simplemente son nerviosos. Una cámara en una VLAN congestionada, una consola que pausa su red durante un guardado de firmware, un dispositivo detrás de un switch que renegocia según su calendario —todos estos pueden desvanecerse de la vista de todos por unos segundos y regresar de inmediato. Así que cada dispositivo monitoreado lleva su propio retraso configurable —60 segundos por defecto— que debe transcurrir, con el dispositivo continuamente inalcanzable, antes de que se dispare una alerta de desconexión.
El consejo práctico de afinación:
- Deja 60 segundos para la mayoría de los dispositivos. Absorbe las renegociaciones de puerto y la congestión momentánea sin retrasar significativamente las alertas reales.
- Alárgalo para dispositivos con rutas conocidamente inestables o interrupciones de red programadas, para que sus mañas se queden fuera del feed de alertas.
- Acórtalo con cautela para dispositivos donde los segundos importan —pero resiste hacer todo instantáneo. Una alerta que se dispara con cada parpadeo de dos segundos es una alerta que el equipo aprende a deslizar para descartar.
Como el retraso es por dispositivo, una cámara temperamental no le impone una configuración lenta a la consola sentada a un salto de switch limpio.
Qué previene este diseño, concretamente
Junta los tres mecanismos —desconectado unánime, la ventana de obsolescencia de 10 minutos, retrasos por dispositivo— y cada escenario clásico de falsa alerta lo atrapa una capa diferente:
- La mala ruta de red de una sola máquina (el escenario de las 3 AM): los otros observadores todavía alcanzan el dispositivo. Veredicto: degradado, no desconectado. Sin alerta.
- Una máquina de cabina se estrella mientras todo lo demás está bien: sus observaciones obsoletas caducan en 10 minutos y deja de votar. Los dispositivos se mantienen en línea sobre la fuerza de los observadores restantes. Sin alerta.
- Todos los observadores apagados por la semana: los dispositivos bajan a obsoleto en lugar de fingir estar en línea —y en lugar de mandar alertas masivas de desconexión por equipo que nadie está observando en realidad.
- Un parpadeo de red de dos segundos que todos ven: el retraso por dispositivo lo sobrevive. Sin alerta.
- Una cámara muere de verdad: cada observador la pierde simultáneamente, el retraso transcurre, y la alerta se dispara —una vez. La misma maquinaria anti-aleteo que gobierna el resto de la plataforma aplica aquí: una alerta por incidente, resolución automática en el feed cuando el dispositivo regresa.
El resultado es un sistema cuyo silencio significa algo. Cuando no llega ninguna alerta, es porque las máquinas de tu edificio están confirmando activamente que tu equipo es alcanzable —no porque el monitoreo se rindió calladamente.
Cómo maneja esto WorshipMetrics
El resumen multi-observador descrito aquí es el comportamiento permanente de Pulse, la capa de monitoreo de WorshipMetrics. Cada máquina que corre la app de escritorio Tech Manager funge también como observador, sus latidos llevan los resultados de sondeo de cada dispositivo marcado “Alertar cuando esté desconectado”, y la nube resuelve los cinco estados —en línea, degradado, obsoleto, desconectado, desconocido— continuamente, tenga alguien un dashboard abierto o no. Los retrasos de alerta por dispositivo se fijan directo en la página de cada dispositivo, las alertas de desconexión se disparan una vez por incidente y se auto-resuelven en la recuperación, y el feed de alertas guarda el historial para que “¿esta cámara ya había hecho esto antes?” tenga una respuesta real.
El domingo de nadie mejora porque una herramienta de monitoreo gritó que venía el lobo a las 3 AM. El resumen existe para que cuando tu teléfono sí vibre, la caminata a la cabina siempre valga la pena.