Introducción
El ministerio multi-sitio crea complejidad técnica más rápido de lo que la mayoría de los equipos espera. Un campus se vuelve dos, luego dos se vuelven cuatro, y de repente tus cámaras, encoders, pantallas, y computadoras de streaming están repartidas entre múltiples edificios con voluntarios diferentes, mañas diferentes, y niveles de documentación diferentes.
En ese punto, la gestión de dispositivos deja de ser solo una tarea AV y se convierte en un requisito operacional para toda la organización. Si tus campus no pueden verse, documentarse, y recibir soporte en un solo sistema, cada domingo depende de la memoria y de la suerte.
Por Qué el AV Multi-Sitio se Descompone
El hardware en sí rara vez es la parte más difícil. La descompostura usualmente viene de cuatro problemas recurrentes:
- ningún sistema de nombrado compartido entre campus
- ninguna visibilidad central de qué está en línea o desconectado
- ningún registro histórico de cambios, fallas, o deriva de firmware
- ninguna forma confiable de que una persona de soporte ayude a otro campus remotamente
En un ambiente de un solo edificio, esos problemas pueden esconderse por mucho tiempo porque la misma gente ve el mismo equipo cada semana. En un ambiente multi-sitio, los huecos se multiplican. Un voluntario del Campus B puede describir una falla muy diferente a como lo haría la persona que originalmente configuró la sala, y si nada está documentado, la conversación de soporte empieza desde cero.
Construye un Inventario Estándar de Dispositivos
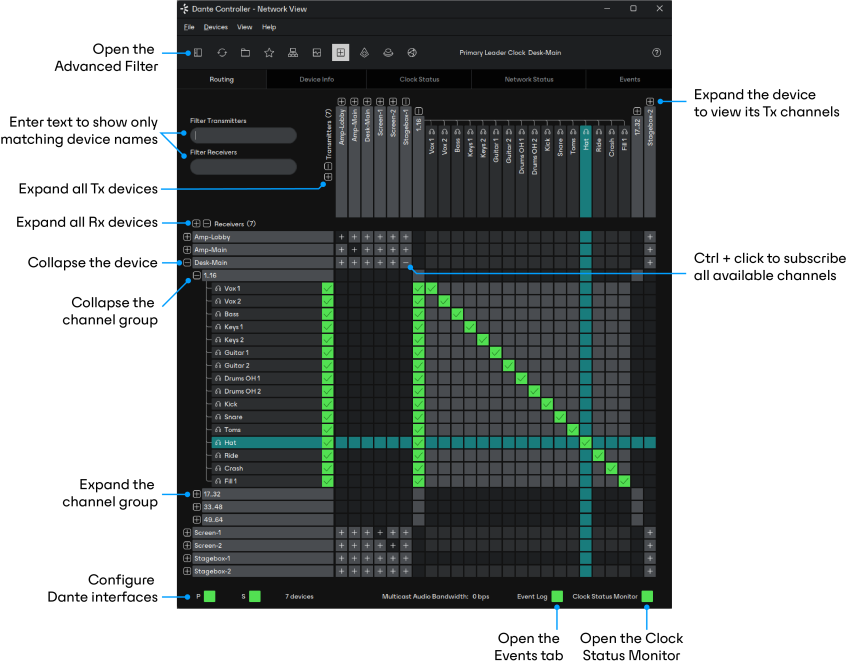
Cada campus debería usar la misma estructura de nombrado para cámaras, switchers, computadoras de streaming, encoders, y pantallas. La meta no es solo el orden. La meta es hacer posibles el soporte remoto y la solución de problemas entre campus.
Un esquema de nombrado fuerte responde tres preguntas de inmediato:
- ¿Qué tipo de dispositivo es este?
- ¿A cuál campus pertenece?
- ¿Dónde vive dentro de ese campus?
Por ejemplo, NST-PTZ-StageLeft-01 le dice a una persona de soporte mucho más que Cámara 2. Una vez que cada campus usa el mismo patrón, la documentación escala y el relevo de voluntarios se vuelve más fácil.
Como mínimo, el inventario debería incluir:
- fabricante y modelo
- número de serie o etiqueta de activo
- dirección IP o identidad de red donde sea relevante
- ubicación física
- rol en la ruta de señal
- versión de firmware
- fecha de reemplazo o estimado de edad
Si el inventario solo te dice qué se compró, no es lo suficientemente útil. Debería decirte cómo el dispositivo encaja en el sistema en vivo.
Separa la Propiedad Local de la Supervisión Central
Los equipos de campus todavía necesitan propiedad local. Ellos conocen la sala, los voluntarios, el flujo del servicio, y las realidades prácticas de ese campus mejor que nadie. Pero la propiedad local no debería significar sistemas aislados.
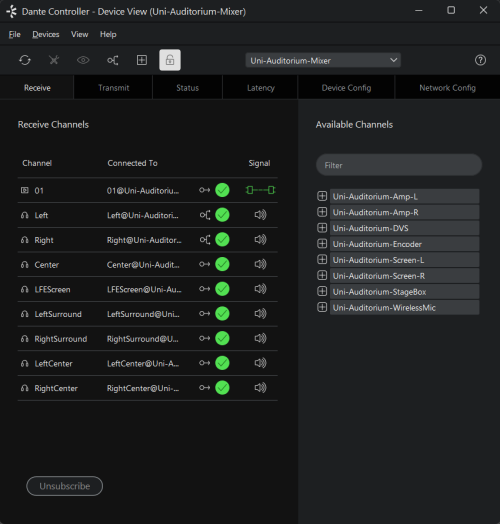
Un modelo multi-sitio sano le da a cada campus independencia operacional mientras mantiene visibilidad central de:
- el estado de los dispositivos
- la salud de la red
- la documentación
- el historial de soporte
- los patrones de fallas recurrentes
Esta es la diferencia entre ministerio distribuido y operaciones fragmentadas. El ministerio distribuido es sano. Las operaciones fragmentadas son caras.
Crea un Ritmo de Mantenimiento Repetible
La revisión regular importa más que la revisión perfecta. Los campus con las menos fallas sorpresa usualmente son los que tienen el ritmo de mantenimiento recurrente más simple, no el conjunto de herramientas más sofisticado.
Para los sistemas AV multi-sitio, ese ritmo debería incluir:
- revisión mensual de firmware para los dispositivos clave
- revisiones trimestrales de cables y conexiones
- inspección regular de baterías y UPS
- revisión de la salud del almacenamiento en las computadoras de producción
- pruebas de velocidad y estabilidad de red en cada campus
- limpieza anual de la documentación
El principio más importante es este: el mantenimiento debería programarse antes de que se necesite. Esperar a que una falla revele una debilidad garantiza que la revisión ya llegó tarde.
Apoya a los Voluntarios con Mejor Contexto
Cuando algo falla el domingo, los voluntarios necesitan más que una lista laminada. Necesitan contexto.
Necesitan saber:
- qué dispositivo está involucrado
- a cuál campus pertenece
- si el problema es local o está afectando a otros campus también
- qué cambió recientemente
- cuál fue el último arreglo exitoso
Ese contexto acorta dramáticamente las conversaciones de soporte. En lugar de gastar diez minutos averiguando qué significa “la caja negra junto al switcher”, tu equipo puede pasar de inmediato al diagnóstico.
Esto es especialmente importante en congregaciones donde la rotación de voluntarios es lo normal. Los buenos sistemas preservan el conocimiento para que la operación no se vuelva frágil cada vez que un voluntario clave se hace a un lado.
Construye un Playbook de Soporte Remoto
El soporte multi-sitio se vuelve mucho menos estresante cuando el equipo ya sabe cómo funciona la escalación remota.
Crea un playbook escrito para preguntas como:
- ¿Quién es el primer respondiente en cada campus?
- ¿Qué problemas deben reportarse de inmediato durante el servicio?
- ¿Cuáles problemas pueden esperar hasta después del servicio?
- ¿Qué capturas de pantalla, nombres de dispositivos, o detalles de logs deben recolectarse primero?
- ¿Quién tiene permiso de reiniciar dispositivos o cambiar configuraciones remotamente?
Sin un playbook, cada campus inventa su propio patrón de soporte bajo presión. Eso lleva a resultados inconsistentes y a tiempo caído innecesario.
Vigila la Deriva, No Solo la Falla
Uno de los retos escondidos del AV multi-sitio es la deriva de configuración. Los sistemas no se rompen todos dramáticamente. Más seguido, silenciosamente se vuelven diferentes unos de otros con el tiempo.
Un campus actualiza el firmware. Otro cambia un perfil de OBS. Un tercero reemplaza una ruta de cable y nunca lo documenta. Ninguno de esos cambios se siente mayor por sí solo, pero juntos convierten un sistema compartido en cuatro sistemas ligeramente diferentes que necesitan, cada uno, una solución de problemas distinta.
Por eso la visibilidad importa tanto. No solo estás vigilando las caídas duras. Estás vigilando la divergencia lenta.
Conclusión
Gestionar dispositivos AV entre campus se trata realmente de la visibilidad del sistema. Una vez que el equipamiento, la gente, y los procedimientos están documentados en un solo lugar, la carga de soporte baja, la consistencia sube, y los voluntarios dejan de cargar más riesgo del que deberían.
La meta no es centralizar cada decisión. La meta es hacer que cada campus sea soportable, entendible, y estable. Cuando eso sucede, tu sistema de producción empieza a escalar con tu ministerio en lugar de pelear contra él.